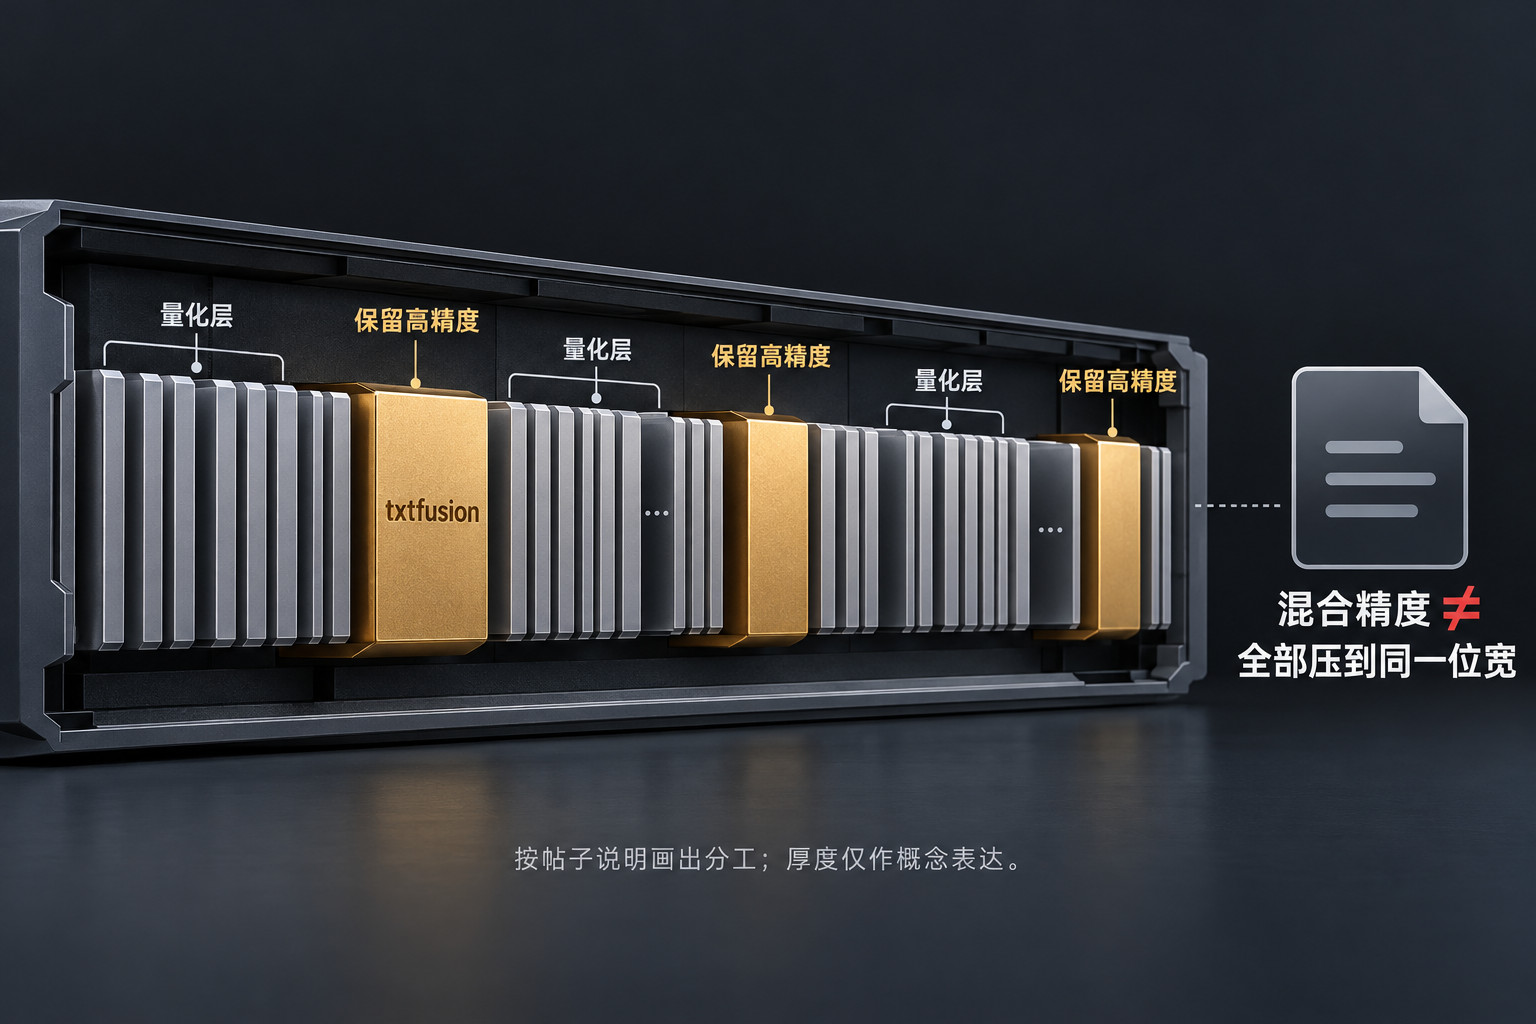
量化版怎么会比别家的还大?第一反应是打包出错,其实是故意的。
Krea 2 这个 w4a8 走的是混合精度,没有一刀切把整个模型压到目标格式,重要的层留在高精度。跟 GGUF 里带 M、XL 后缀那套是一个思路:多花点体积,换回质量。
对叠 LoRA 的人最有用的是这条:txtfusion 层全部保高精度。专门动 txtfusion 的那类 LoRA 最怕叠在低精度层上,效果对不上,你还查不出原因。这层不动,排查时就少了一个怀疑对象。
另外两件顺带的事。作者宣布 scaled fp8 和 nvfp4 弃用,建议换 int8convrot 或 w4a8,说是更快精度也更好;配套的 qwen3vl 文本编码器也有量化版,用的时候两边版本对齐。